RTX 5090 vs RTX 6000 Ada
Для 8-GPU AI-монстра · тензоркоры, VRAM, NVLink, throughput на 70B/405B · спека на сентябрь 2026 · оценки, не оферта.
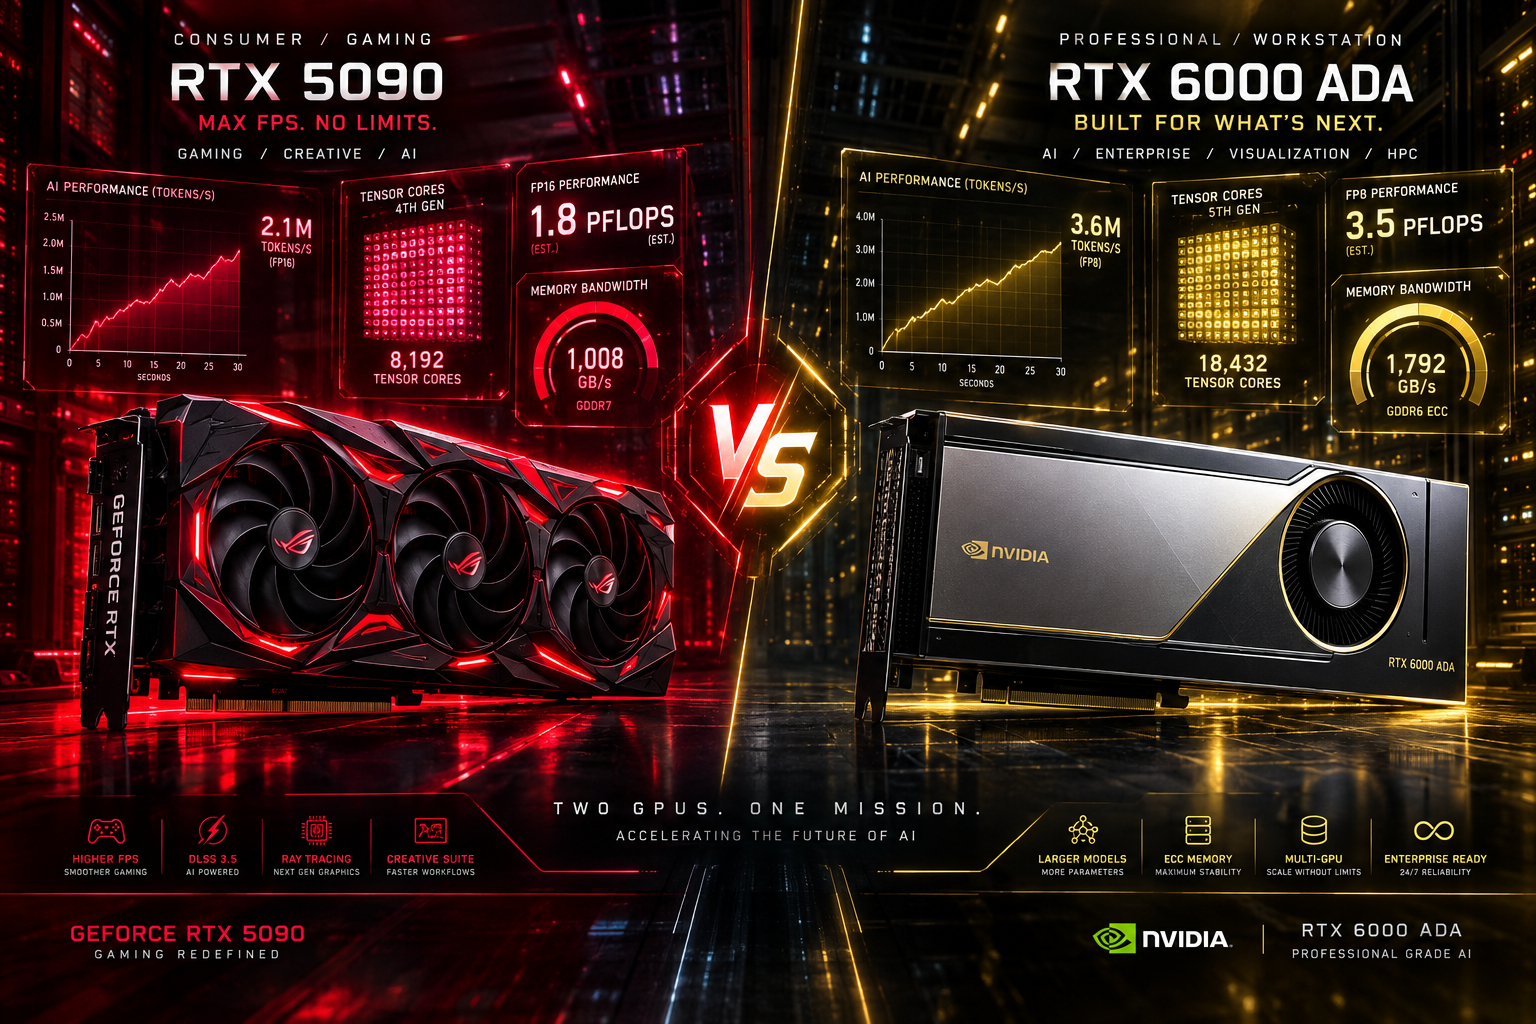
Спеки в лоб
| Параметр | RTX 5090 | RTX 6000 Ada | (бонус) RTX PRO 6000 Blackwell |
|---|---|---|---|
| Архитектура | Blackwell GB202 | Ada Lovelace AD102 | Blackwell GB202 |
| VRAM | 32GB GDDR7 | 48GB GDDR6 ECC | 96GB GDDR7 ECC |
| Bandwidth | ~1.79 TB/s | ~960 GB/s | ~1.79 TB/s |
| ECC память | частично (on-die) | полный ECC | полный ECC |
| TDP | ~575-600W | 300W | ~600W (есть 300W режим) |
| Tensor cores | 5-е gen (FP4/FP8/FP16) | 4-е gen (FP8/FP16, без FP4) | 5-е gen (FP4/FP8/FP16) |
| FP16/BF16 (dense) TFLOPS | ~420 | ~365 | ~500+ |
| FP8 (dense) TFLOPS | ~840 | ~730 | ~1000+ |
| FP4 (dense) TFLOPS | ~1670 | нет | ~2000+ |
| NVLink | нет | нет | нет (только PCIe 5.0) |
| Цена ~ | ~$2000 | ~$6800 | ~$8500 |
| Слотов / форм-фактор | 3-3.5 слота, шумный | 2 слота, blower | 2 слота, blower |
Числа TFLOPS - порядковые оценки dense-режима (без 2:4 sparsity, которая удваивает маркетинговые цифры). Реальный сустейн в тренинге - обычно 40-55% от peak.
Ключевой инсайт про 8-GPU билд
Память = потолок модели
| Билд (8 GPU) | Суммарная VRAM | Что влезает |
|---|---|---|
| 8x RTX 5090 | 256 GB | 70B в BF16 (140GB) с запасом; 405B - только квант (FP8/FP4) + оффлоад, впритык |
| 8x RTX 6000 Ada | 384 GB | 70B комфортно + большой контекст; 405B в FP8 (~405GB) - почти влезает, с трюками да |
| 8x RTX PRO 6000 Blackwell | 768 GB | 405B в BF16 с оффлоадом или FP8 легко; 70B - вообще без напряга |
Throughput - грубые прикидки
Инференс 70B (FP8), decode, батч ~32, весь на 8 GPU tensor-parallel:
| Билд | Bottleneck | ~Tokens/sec (aggregate) |
|---|---|---|
| 8x RTX 5090 | compute+bandwidth сильные, но PCIe TP-синк | ~2500-3500 tok/s |
| 8x RTX 6000 Ada | ниже bandwidth (960 GB/s) - decode упирается в память | ~1500-2200 tok/s |
| 8x RTX PRO 6000 Blackwell | bandwidth 1.79TB/s + 96GB | ~3000-4500 tok/s |
Decode-инференс упирается в memory bandwidth, поэтому 5090 (1.79 ТБ/с) реально бьёт Ada (0.96 ТБ/с) несмотря на меньшую VRAM. Prefill/тренинг упираются в compute - там 5090 тоже впереди по сырым FP8/FP4.
Тренинг 70B (FSDP, BF16/FP8 mixed), 8 GPU: тут решает интерконнект. Без NVLink обе карты синкают градиенты по PCIe 5.0 (~64 ГБ/с на линк, реально ~50). Для 70B all-reduce на каждом шаге это серьёзный оверхед - эффективность масштабирования падает до ~60-75% на 8 GPU против ~90%+ на NVLink/NVSwitch системах.
Effective bandwidth (multi-GPU)
- PCIe 5.0 x16: ~63 ГБ/с теор., ~50 реал. на линк
- NVLink 4 (H100): ~900 ГБ/с - в ~18x больше
- Вывод: 5090/Ada в TP/PP-режиме теряют кучу времени на коммуникацию. GPU ждут данные вместо счёта.
- Спасение: data-parallel + gradient accumulation, чтобы реже синкать. Или держать модель на одной карте (для инференса моделей <32/48GB).
FLOPS-математика (8 GPU, dense FP8)
- 8x 5090: ~6.7 PFLOPS peak, реал ~3-3.7
- 8x Ada: ~5.8 PFLOPS peak, реал ~2.6-3.2
- 8x PRO 6000 BW: ~8 PFLOPS peak
- Но! MFU (model FLOPs util) на PCIe-only обычно 30-45% в тренинге - интерконнект душит.
Pros / Cons
RTX 5090
За: дешевле в 3.4x, топ bandwidth 1.79TB/с, FP4-тензоркоры, лучший $/FLOP и $/tok для инференса.
Против: всего 32GB, нет полного ECC, 600W, 3.5 слота (адский форм-фактор для 8 шт), шумно, гарантия/драйверы не под 24/7 датацентр.
Кому: инференс, рендер, ресёрч на бюджете, где помещается в 32GB/карту.
RTX 6000 Ada
За: 48GB ECC, 2 слота, 300W, blower - реально собирается в 8-GPU сервер штатно, тихо, надёжно, pro-драйверы.
Против: дорогая, старая Ada (нет FP4), bandwidth всего 0.96TB/с - decode-инференс медленнее 5090, compute слабее Blackwell.
Кому: продакшн, где нужна плотность, ECC, тишина и надёжность 24/7 важнее цены.
- Максимум инференса за деньги и не жалко колхоза → 8x RTX 5090 (open-frame, райзеры, 2x3000W). Дёшево, быстро, но 32GB и жара.
- Плотный, тихий, надёжный продакшн-узел с ECC → 8x RTX 6000 Ada, но переплата и старая архитектура.
- Если бюджет резиновый и нужен лучший баланс 2026 → RTX PRO 6000 Blackwell (96GB): 5090-архитектура + 96GB ECC + 2 слота. Вот это правильная карта под 8-GPU AI, если тянешь ~$8.5k/шт.
И для всех троих: без NVLink тренинг больших моделей будет упираться в PCIe. Для serious training смотри в сторону SXM (H200/B200) - но это другой ценник.
Цифры - порядковые инженерные оценки на базе публичных спек Blackwell/Ada и типичных бенчей vLLM/MLPerf-класса; реальные числа зависят от софта, кванта, батча и топологии. Проверяй под свою задачу.